
Folgendes wird mit SEO und KI/LLMs zu tun haben, aber ich versuch mich einmal mehr an einer anderen Flughöhe. In die Richtung grübelte ich schon mit dem Fokus „Organisation des gesellschaftlich als bekannt voraussetzbaren Wissens“ in Bezug auf die Wiki und ihre (durchaus begründet) anstrengenden Prozesse. Ebenso entlang eines sehr dankbaren Beispiels der KI-befeuerten Diskursvermüllung und Informationsvergiftung durch die Grokipedia. Weiter haben wir es mit durchaus paradox agierenden Akteuren zu tun, wenn einerseits Google alles mit Gemini/AI-Boxen beantworten will, was man es fragt („für euch ist das gut genug!“) und parallel dazu den Output als unzuverlässig markiert („Für uns müsst ihr schon selber den Kopf anstrengen!“). Zu guter Letzt habe ich eine etwas naive Idealvorstellung, was SEO auch und Webtech überhaupt sein kann und sollte, über die ich gelegentlich zwar auch selber grinse, aber dann doch immer wieder feststelle, sie hat ein Plätzchen in meiner Mördergrube und tief, tief in mir drin will ich, dass es so ist bzw. wird. Also.
Weltwissen. Seit den Altvorderen sah ich bislang sehr grob zwei Ansätze zu seiner Organisation und Erschließung, und die nannte ich mal ganz hemdsärmelig
– kuratiert und
– algorithmisch. Was stell ich mir jeweils darunter vor?

Antworten!
Kuratierte Wissensorganisation ist menschengemacht, mit allen Vor- und Nachteilen, die das mit sich bringt. Von Kanonisierung über Verschlagwortung, Katalogisierung off- wie online, redaktionelle Erschließung etc., hier kamen wir einen langen Weg. Der beginnt mit überlieferten Geschichten und Texten (man mag natürlich an Sagen und die Bibel denken, ich denke da gern an das dothrakische „das ist bekannt“, weil es genau das auf den Punkt bringt, um was es mir geht: was gilt als bekannt und akzeptiert, letzteres zumindest als Grundlage für weitere Erörterung?) Und ich treibe nun hoffentlich die vergröberte Einordnung in die großen Diskurse nicht zu weit: daran male ich ein großes „ANTWORTEN“ auf die großen Fragen „Was können wir wissen, was sollen wir glauben, was dürfen wir hoffen“. Wer steuert und entscheidet dabei? Da kann man natürlich den Foucault auspacken oder sich in verschiedensten Herrschafts- und wissenssoziologischen Bereichen austoben, an der Stelle genügt mir aber ein „Menschliche Akteure und Strukturen“.
Weiter überspringe ich mal die wissenschaftlichen Revolutionen und das Bibliothekswesen und konstatiere tapfer, dass sich solche Strukturen über die kurz angerissenen Techniken bis heute gehalten und fortentwickelt haben und man ihre Wirkmacht in unterschiedlichsten Bereichen sah und sieht: das Prinzip kennt man von Webkatalogen wie DMOZ selig und seinerzeit Yahoo, in Kontexten wie Blogrolls und Social Bookmarks, (natürlich) bei der Wikipedia, im wissenschaftlichen Zitationswesen und mit DOI, ich würde soweit gehen und sagen, HTML selber war quasi eine Einladung, Weltwissen zu kuratieren iSv. „es sinnvoll zu verknüpfen“. Wir haben drei Auffälligkeiten: zum einen das Grundprinzip des konkreten, zuordenbaren menschlichen Handelns, zum anderen die Notwendigkeit einer aktiven Erschließung, zum Dritten das allenfalls mittelgute Skalierungspotential.
Algorithmische Wissensorganisation hat dieses letzte Problem nicht. Man wirft alles rein, was da ist bzw. was drin sein soll, und dann baut man etwas, um im entstandenen großen Haufen genau das zu finden, was man braucht. Es fing mit primitiven Volltextsuchen an, die Strings verglichen und dann kam viel cleveres Zeug obendrauf. Und in den letzten paar Jahrzehnten skalierte das hervorragend. Erschließung der Inhalte ohne weiteres Drumrum seh ich trotz (oder wegen) neuerer Wiederentdeckungen wie IndexNow als gesetzt. Von konkretem, zuordenbaren menschlichen Handeln ist hingegen sukzessive weniger die Rede, und hier lande ich bei „Ruppsels Theorie von SEO als grundsätzlich nicht verkehrter Kiste“. Idealistisch, ich weiß, aber bear with me.
Denn grundsätzlich sehe ich zwischen den beiden genannten Ansätzen (noch) einige Überschneidungen. Ein menschlich kuratierter Korpus wie meinetwegen eine Unibibliothek der Achtziger ist durchaus abhängig von sowas wie „Algorithmen“ und ihrem Funktionieren. Wenn die Verschlagwortung, Sortierung etc. nicht funktioniert, findet man nichts. Wenn ich nicht weiß, wie ich eine Verschlagwortung verwende, finde ich nichts. Und so weiter. Man hat eine Methode zur „Indexierung“ des Korpus und man hat eine Methode zum Stellen von Rechercheanfragen, und beide müssen funktionieren.
Dieses Konzept wurde von modernen Suchmaschinen nur einigermaßen auf die Spitze getrieben und dabei von eurem werten Autor und seinen Kollegen seit Jahren gegamed. Wer sich an eine Suchmaschine wendet, will eine Antwort auf eine Frage, eine Lösung für ein Problem. Wer einen Suchalgorithmus baut, will möglichst gute Antworten auf gestellte Fragen finden, möglichst passende Lösungen für eine Problemstellung. Dabei ist man abhängig von den vorab erstellten Antworten/Lösungen, die im Korpus idealerweise vorliegen, weiter von einer Frage- bzw. Problemstellung auf Nutzerseite, anhand derer man erstere sinnvoll ermitteln kann. Zuletzt braucht es eine Methode (einen Algorithmus) zur erwähnten Ermittlung eines Resultats, das zur Anfrage passt.
Dieser Dreisatz scheint mir lange einigermaßen konstant geblieben zu sein. Wenn ich zum Katalog der Unibibliothek gehe und wissen will, wie das Wechselverhältnis von reformiertem Christentum und Kapitalismus im Süddeutschland der Industrialisierung aussah, schaue ich nach den entsprechenden Schlagwörtern und lande wahrscheinlich bei Webers protestantischer Ethik. Wenn ich wissen will, warum die Schwaben als so fleißig gelten, lande ich eher bei Gerhard Raff. Ich muss fähig und in der Lage sein, meine Frage in eine Suchanfrage herunterzubrechen (meine Schlagworte), im Korpus sollten passende Antworten enthalten sein (Raff und Weber), und der Algorithmus muss funktionieren (dem Weber muss die protestantische Ethik, dem Raff die schwäbische Folklore zugeordnet sein, man muss sie an der jeweils angegebenen Stelle im Regal dann finden).

Historischer Übersetzungs-Algorithmus
Der Haken? In der Unibibliothek wird der „Algorithmus“ von entsprechend ausgebildeten Leuten beliebig transparent entwickelt, betrieben und umgesetzt. Was nicht im Katalog steht, kann ich nicht finden. In der Suchmaschine gibt es Akteure, die Algos bauen, andere Akteure, die Regale einräumen, Leute, die texten und verschlagworten und zu guter Letzt welche, die den Algo betreiben und anbieten und dabei niemandem verraten, wie er funktioniert (aber immerhin: Leute.). Zuletzt braucht sich bei den Fragenden niemand an irgendwelche Verschlagwortungssysteme zu halten, sondern fragt halt so clever bzw. blöd, wie es das Hirn halt hergibt, und die Bandbreite ist enorm. Zu guter Letzt kommen noch Leute dazu, die behaupten, eine oberstufentaugliche Einführung in „Die protestantische Ethik und der Geist des Kapitalismus“ mit Verstehensgarantie in fünf Minuten zu liefern und nach dem Klick hat man ein kostenloses Zugangstool für japanische Pornografieseiten installiert.
Auf abstrakterer Ebene: statt einem durch benannte Akteure kuratierten Prozess hat man einen, der von zahlreichen verschiedenen, nicht unbedingt bekannten Akteuren mit teils fragwürdigen Motiven gemeinsam bespielt wird und entsprechend permanenter Nachjustierung bedarf, soll er im Sinne der Nutzenden funktionieren.

So lernten wir damals googlen
In einer idealen Welt wäre SEO an sich genau die Methode, die hier für optimale Ergebnisse sorgt. Ziel ist, genau die Leute zu erreichen, deren Problem man lösen/deren Frage man beantworten kann. Idealerweise erreicht man sie mit ihren Fragestellungen und Problembeschreibungen, weiter nur sie, denn andere Fragen/Probleme beantwortet und löst man ja nicht, als Publikum sind sie entsprechend wenig interessant. Im Ergebnis hat man ein Bibliotheks-Verschlagwortungssystem auf Steroiden, weil eben nicht nur der arme Gehilfe die Neuerscheinungen nach bestem Wissen und Gewissen verschlagwortet, sondern weil zahlreiche Akteure sich die ganzen möglichen Verschlagwortungen überlegen, mit denen Bibliotheksbesucher nach ihren Texten suchen könnten. Dazu ein paar automatische Feedbackloops (Schlagworttauglichkeit messen via Bounces etc.), und man hat ein einfaches, selbstoptimierendes und skalierendes System, in dem alle Beteiligten alle etwaigen Anfragen so gut wie möglich beantworten, lösen oder sonstwie zur (messbaren) Zufriedenheit bearbeiten. Was schlechter ist, klickt schlechter.
Bei dieser idealistischen Beschreibung springen mir nach der LLM-Eskalation ironischerweise verstärkt die Gemeinsamkeiten zum „kuratierten“ Modell ins Auge, wo ich bislang immer die beiden „antagonistischen Herangehensweisen“ sah (grob: „Google vs. Wikipedia“ in Sachen Wissensorganisation und -erschließung). Sie haben jeweils die benennbaren Stellschrauben, an denen Akteure aussteuern. Die sind mal offengelegt und möglicherweise gar Gegenstand kontinuierlicher, kollektiver Entwicklung (z.B. Wiki-Relevanzkriterien), mal öffentlich und vorgegeben (Googles Webmasterrichtlinien) bis hin zu nichtöffentlich oder gar Geschäftsgeheimnis (z.B. konkrete Rankingalgorithmen Googles), aber es sind benennbare und zugängliche Stellschrauben, mit deren Vorhandensein eine gewisse Verantwortung der Stellschraubendreher fürs Funktionieren des Gesamtsystems einhergeht. Zu guter Letzt sind die Ergebnisse jeweils zumindest prinzipiell reproduzierbar.
Nur sind das auch die Faktoren, die aktuell aus den Gleichungen gestrichen werden.
Benennbare Stellschrauben. Vor knapp zwei Jahren meldete Google höchstselbst, dass sie ihr Kernprodukt leider nicht mehr aussteuern können, und seitdem hat sich nichts verbessert. Vor sechs Jahren erläuterte ich Knowledgegraphen am Beispiel einer für SEOs schmerzhaften, für Nutzer aber überaus nützlichen, soliden Information zum lokalen Kinoprogramm, die aus benenn- und prüfbaren Datenquellen gespeist wird:
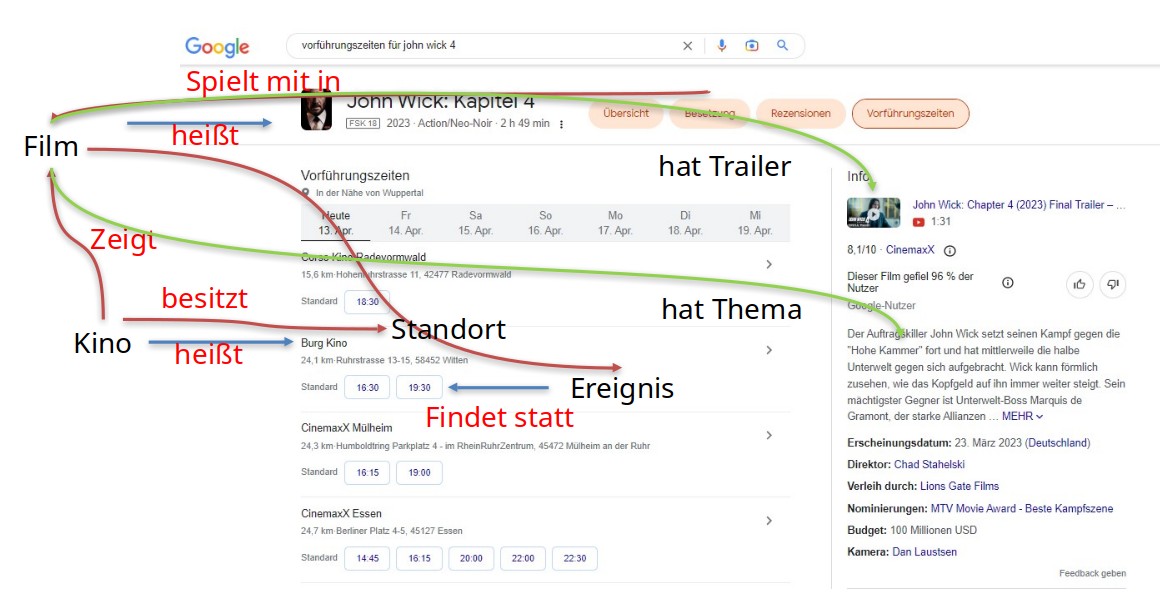
Knowledge-Graph-Strukturen in Google-SERPs, Beispiel John Wick 4
Witzigerweise existiert diese grundsolide Technik aktuell, wenn ich die Odyssee gucken will…

Knowledge Graphen 2026, still going strong!
…bei Spiderman solls dann die KI richten und tuts erstmal nicht…

KI müde. KI muss jetzt schlafen.
…und dann doch, nur aber: ernsthaft?

Für diese Veranschaulichung mussten sechs Kätzchen verdursten und ich werd den Film nicht mal gucken.
Da hattet ihr die Feeddaten der Kinos strukturiert, text/plain/utf8 und musstet nur CSS drumrumbauen, und jetzt brauchts eine Gasturbine und ein Rack voller Google TPUs, um da was zusammenzumalen, was auf den dritten Versuch geladen wird und wahrscheinlich stimmt?
Aussteuernde Akteure. Siehe oben, Akteure ja, steuern nein. Bzw., wenn es was in Bezug auf „Erschließung des Weltwissens“ zu steuern gibt, dann eben auf die für LLMs typisch unscharfe Art und Weise. Ich rede hier nicht von Codingagenten oder einem Buchungsassistenten für Pizzadienste, es geht um die Abbildung verfügbaren Weltwissens für Leute, die selbiges wollen, und die typischen Unterschiede der großen Modelle betreffen Faktoren wie Tonfall, Servilität und überhaupt und am wichtigsten, politische Grundhaltung. Wie diese jeweils getuned sind, ist selbstredend nichtöffentlich und ob es sie in der Form gibt? Selbst Musk hat offenbar das Interesse an seiner Fascho-Enzyklopädie verloren, man mag ja hoffen, weil selbst er es nicht schaffte, per KI eine konsistent herrenmenschliche Gegenrealität zu konstruieren, alleine, ich denk eher, die Kohle wird knapp und an Antrophic vermieten bringt ne Milliarde im Monat und seine Fanboys lesen eh keine Enzyklopädien.
Verantwortet wird natürlich gar nichts mehr. Für die Ergebnisse kann niemand was, und Reproduzierbarkeit ist qua definitionem nicht gegeben. Trotz allem bzw. deswegen haben wir nun gesellschaftlich wirkmächtige, technische Strukturen, die über alles einen zusätzlichen Abstraktionslayer plus Gaußschem Weichzeichner unbekannter Größe legen.
Ich sehe da bei der „gemeinsamen Organisation des Weltwissens“ eine Streichung von „gemeinsam“ und „Welt“, und über „Organisation“ sowie „Wissen“ kann man sich streiten. Klar, ich bin einer der Dinosaurier, der das Gefühl hat, seit ein paar Jahren wird die Suche einfach immer schlechter, aber geschenkt, dass sie schlechter wird, ist ein Nebeneffekt einer Entkoppelung von Realität und Aufbereitung, für die praktischerweise niemand mehr was kann.
Nun mag man anmerken, diese „Entkoppelung“ gibt es seit Anbeginn medial vermittelter Kommunikation, die erzählte Göttersage ist nicht die Wirklichkeit und RTL2 nicht Duisburg, warum soll nun eine Google-SERP auf einmal die Welt abbilden? Die SERP muss das gar nicht, aber das Zustandekommen von Aussagen, Botschaften, Informationen braucht eine Nachvollziehbarkeit, wenn man sie als Weltbeschreibung akzeptieren will. Es ist prinzipiell rekonstruierbar, wenn und warum zwei Leute mit ähnlichen Fragen in die Unibibliothek gehen und der eine mit dem Raff und der andere mit dem Weber unterm Arm rauskommt. Wenn man sich Unterschichtenporn auf RTL2 gegeben hat, wird man sich jeweils was zu den gezeigten wie auch zu den medienschaffenden Menschen denken können, wahrscheinlich mehr über letztere. Jegliche Übung zum Thema „Medienkompetenz“ fängt bei den Basics an, WER mir WAS zeigt und WARUM, und WARUM WAS NICHT. Die Frage nach dem WER entfällt gerade mangels Akteur, die nach dem WARUM ebenso mangels Motiv, und was von der Medienkompetenz anschließend übrigbleibt, ich weiß es nicht?
Wie eingangs bemerkt: ich bin da grade dabei, mein Hirn drumzuwickeln, und ich ahne, es lässt sich klarer und besser weiterdenken. Ganz groß gedacht, habe ich grade das Gefühl, dass wir uns die Werkzeuge zur gemeinsamen Beschreibung der Wirklichkeit aus der Hand nehmen lassen. Klein gedacht bin ich wahrscheinlich nur gekränkt, weil bisher verfügbare Strukturen zur Kuratierung von Weltwissen halt grade eingestampft werden und ich mich deswegen nicht mehr ausreichend privilegiert mitspielend fühlen kann. Allein, wer spielt denn dann noch?
Aber immerhin, grobmotorische Holzarbeiten. Und Katzenbilder.

Schreibtischkater auf grobmotorischer Holzarbeit

Hey – es ist schon ein Elend, wie sehr diese Infrastruktur den Bach runtergegangen ist. Ich weiß noch, früher… von Metacrawler zu google war revolutionär.
Hast du dir schon mal https://kagi.com angeschaut? Hab ich damals über Cory Doctorov entdeckt und wird das letzte Abo sein, das ich in meinem Leben kündige. Ist zwar scheiße, für etwas zahlen zu müssen, was vor 10 Jahren einfach so funktioniert hat, aber dafür funktioniert es wenigstens weiterhin.
Moin,
ja, Kagi verfolge ich schon ne Weile und mit schwindendem Wohlwollen, da ist mir auch etwas viel Rumgerudere mit KI dabei und irgendwie ist mir die Leitung auch ein wenig suspekt, aber das sind Befindlichkeiten.
Mir gehts aber gar nicht so um den Punkt „wohin kann ich ausweichen?“, sondern um den Impact auf ein gesellschaftlich geteiltes oder meinetwegen konstruiertes Bild der Realität. Das wird eben von den großen Strukturen geformt, und da macht es einen Unterschied, wenn die großen Player einen nichtmenschlichen und von niemand mehr verantworteten Layer drüberlegen. Und ob ich oder du dann mit Kagi suchen, spielt für diese Fragestellung grundsätzlich keine Rolle.
Nachtrag; aber danke fürs Anstupsen, immerhin hab ich jetzt endlich Kagi (Suchmaschine) geschrieben :)